Fini le stock footage : des personnages IA pour la formation
Ma recette complète pour créer des personnages et des lieux cohérents en formation eLearning, du design au passage image-vers-vidéo.
Il faut qu’on se parle de l’utilisation du stock footage générique dans les formations. Ou pire : les petits bonhommes animés.
C’est quelque chose qu’on tolère comme un mal nécessaire de la formation eLearning depuis 15 ans.
Les apprenants qui suivent les formations, ils sont comme vous en moi. Ils regardent aussi Tiktok Youtube et Netflix.
Alors regarder une formation plate avec du contenu générique, c’est comme leur donner une punition.
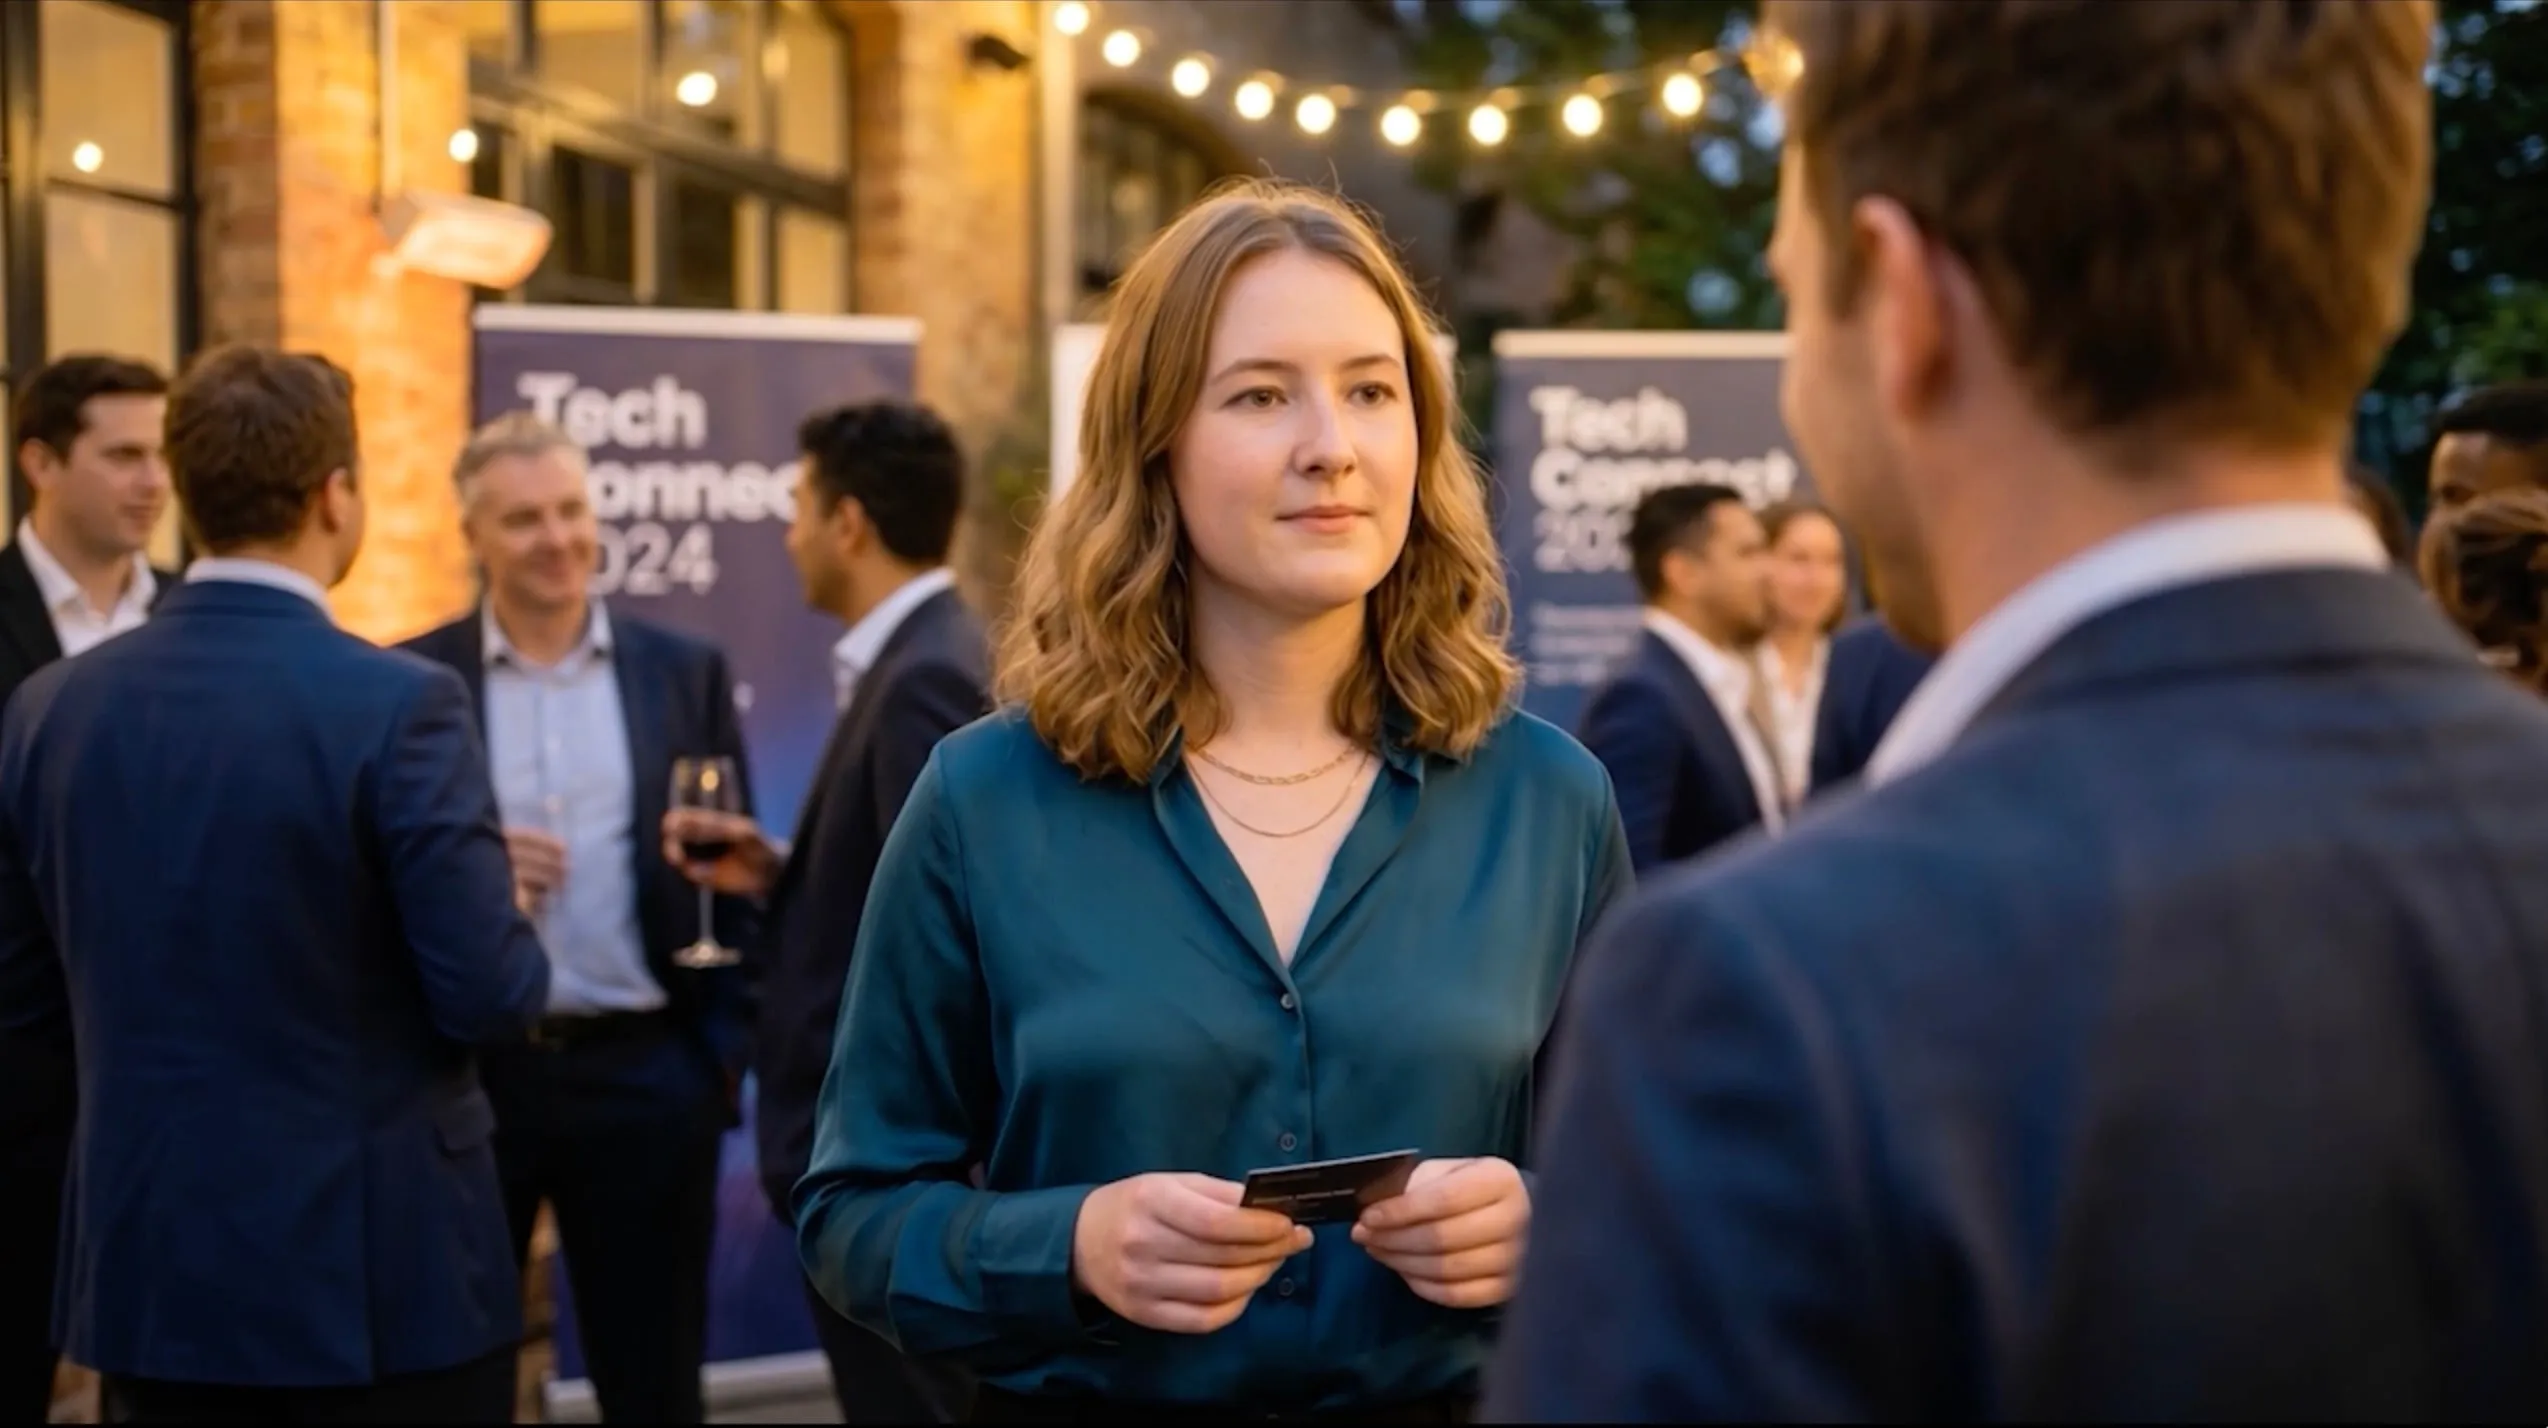
La cohérence des personnages et des lieux en AI générative, c’est réglé depuis un moment. On peut enfin créer de vraies mises en situation, avec de vrais personnages récurrents qui incarnent le contenu.
Là ça devient intéressant.
On vient justement de livrer 30 minutes de footage AI pour une formation. Une vingtaine de situations, une communauté de 10 personnages cohérents, des lieux récurrents, des actions, des histoires.
Je vous dévoile la recette tant qu’à faire.
(Bon étape 0, c’est de rédiger le plan, le texte et décider de l’approche pédagogique)
1. Design personnage et lieux
Brainstorm rapide dans Midjourney. Quand un personnage (ou lieux) nous parle, on le “stabilise” dans Nano Banana.
2. Slate personnage et lieu
On crée une slate de personnages dans plusieurs émotions, sous plusieurs angles. Même travail pour les lieux, sous le plus d’angles possibles.
3. Brainstorm massif
On pourrait être tenté de tout prompter manuellement, une image à la fois.
Mais les workflows actuels permettent de faire ça en batch, et c’est là que ça devient intéressant. On a fait un immense brainstorm de toutes les images dont on aurait avoir besoin pour raconter l’histoire. On converti ce brainstorm en listes structurées.
4. Workflow de création d’images
On utilise Freepik Spaces (mais ComfyUI ou Weavy font la même job) : dans un workflow, on importe personnage, lieux et la liste des scènes / situations à générer. On batch ensuite des centaines d’images en parallèle à la fois. On sélectionne, on corrige, on ajuste pour obtenir ce qu’on va vraiment animer.
5. Image vers vidéo
Décrire l’action de chaque image à la main, ça aurait pris des jours. Kling et Veo 3 sont très bons pour interpréter l’image et deviner le moment d’action qu’elle représente.
Deux approches : on fait confiance à l’outil avec un prompt minimal (un simple “slow motion” fait souvent la job), ou sinon un workflow lit la scène et génère le prompt pour nous. Les deux s’automatisent.
Pour certaines actions très précises qu’on avait absolument besoin, on a prompté manuellement.
6. Montage
Il existe des workflows pour monter automatiquement, mais à cette étape, on a absolument besoin de la touche humaine pour raconter l’histoire. Le monteur traite donc ce matériel comme n’importe quel vidéos sources.
Le résultat : des vrais histoires avec personnages, dans des scènes qui auraient coûtés 100k à filmer… pour une fraction du prix et du temps.